副歌
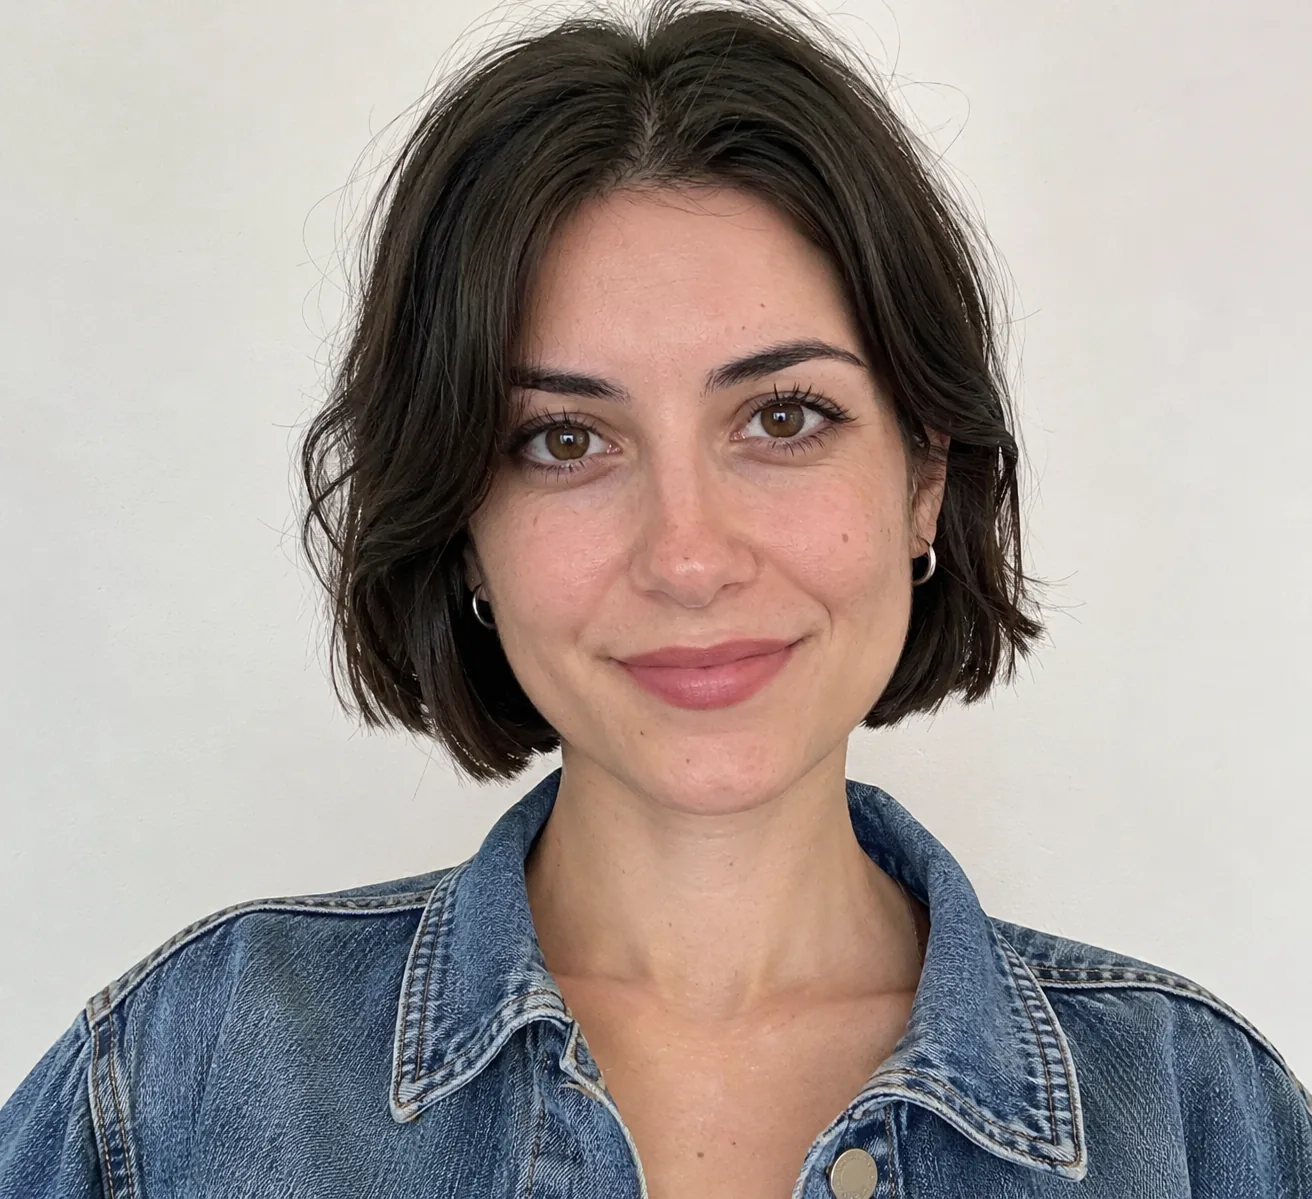
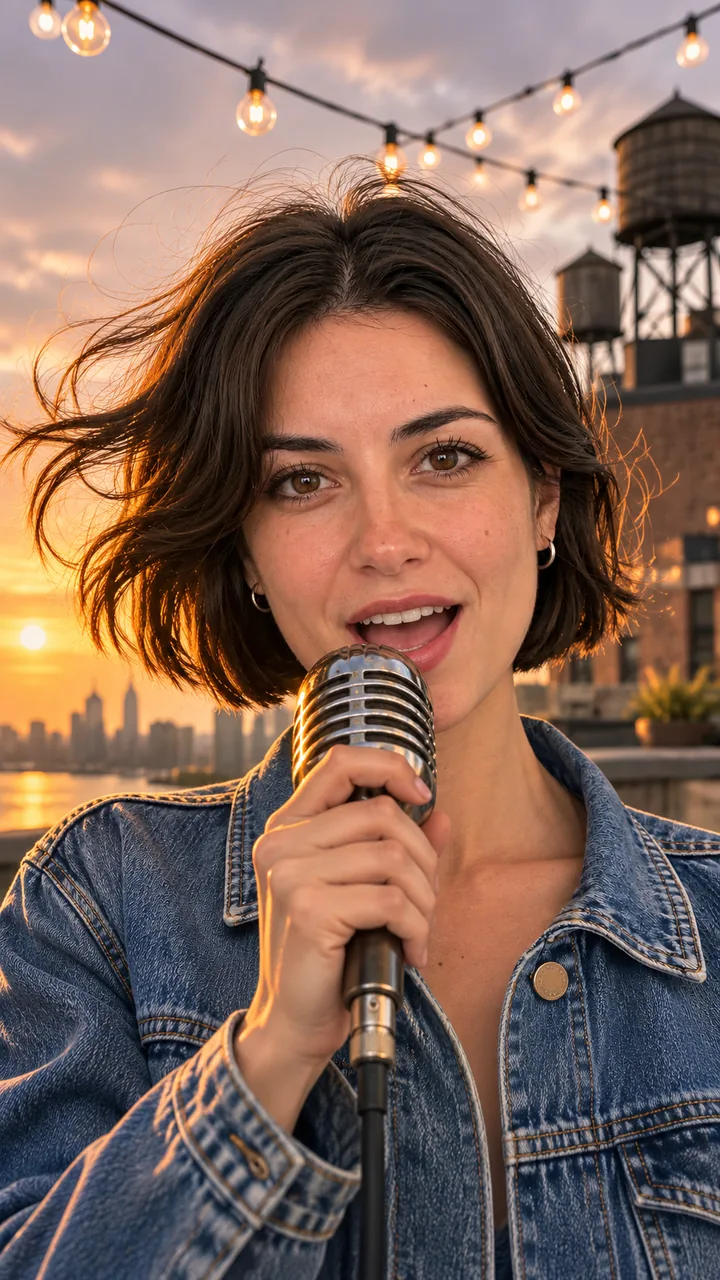
改編自 lovart.me 片段:Seedance 2.0 Fast,10 秒,9:16,720p,以一段 12 秒、帶無歌詞 la-la 旋律的原創合成流行副歌(Suno V6)作為音訊參考;聲音由模型依該參考生成 · 依節拍重新剪輯、重新取景、調色 · 未再進行 AI 生成 · 製作於 2026-11-05
做一首歌或帶入現成的歌,為副歌製作靜態圖,按下「讓它動起來」,再對主歌和 Drop 重複一次,最後把片段接到歌曲上。
本次作品
我的作品結果會顯示在這裡,也會存進「我的作品」;生成失敗時積分會退回。
兩段直式片段,分別取自原創歌曲的合成流行副歌與 lo-fi 主歌,由 10 秒的 lovart.me 原片為本頁重新剪輯,旁邊附有四個段落的靜態圖。副歌剪輯約 8 秒,約 122 BPM:先用兩秒特寫歌手站在復古麥克風前,接著切到她的側臉,鏡頭拉遠,呈現黃金時刻的整個屋頂。主歌循環約 9.5 秒,約 77 BPM:一位音樂人彈著小型鍵盤,鏡頭飄向下雨的窗戶和桌燈,再回到他身上。兩段都有聲音,請在播放器中開啟。
改編自 lovart.me 片段:Seedance 2.0 Fast,10 秒,9:16,720p,以一段 12 秒、帶無歌詞 la-la 旋律的原創合成流行副歌(Suno V6)作為音訊參考;聲音由模型依該參考生成 · 依節拍重新剪輯、重新取景、調色 · 未再進行 AI 生成 · 製作於 2026-11-05
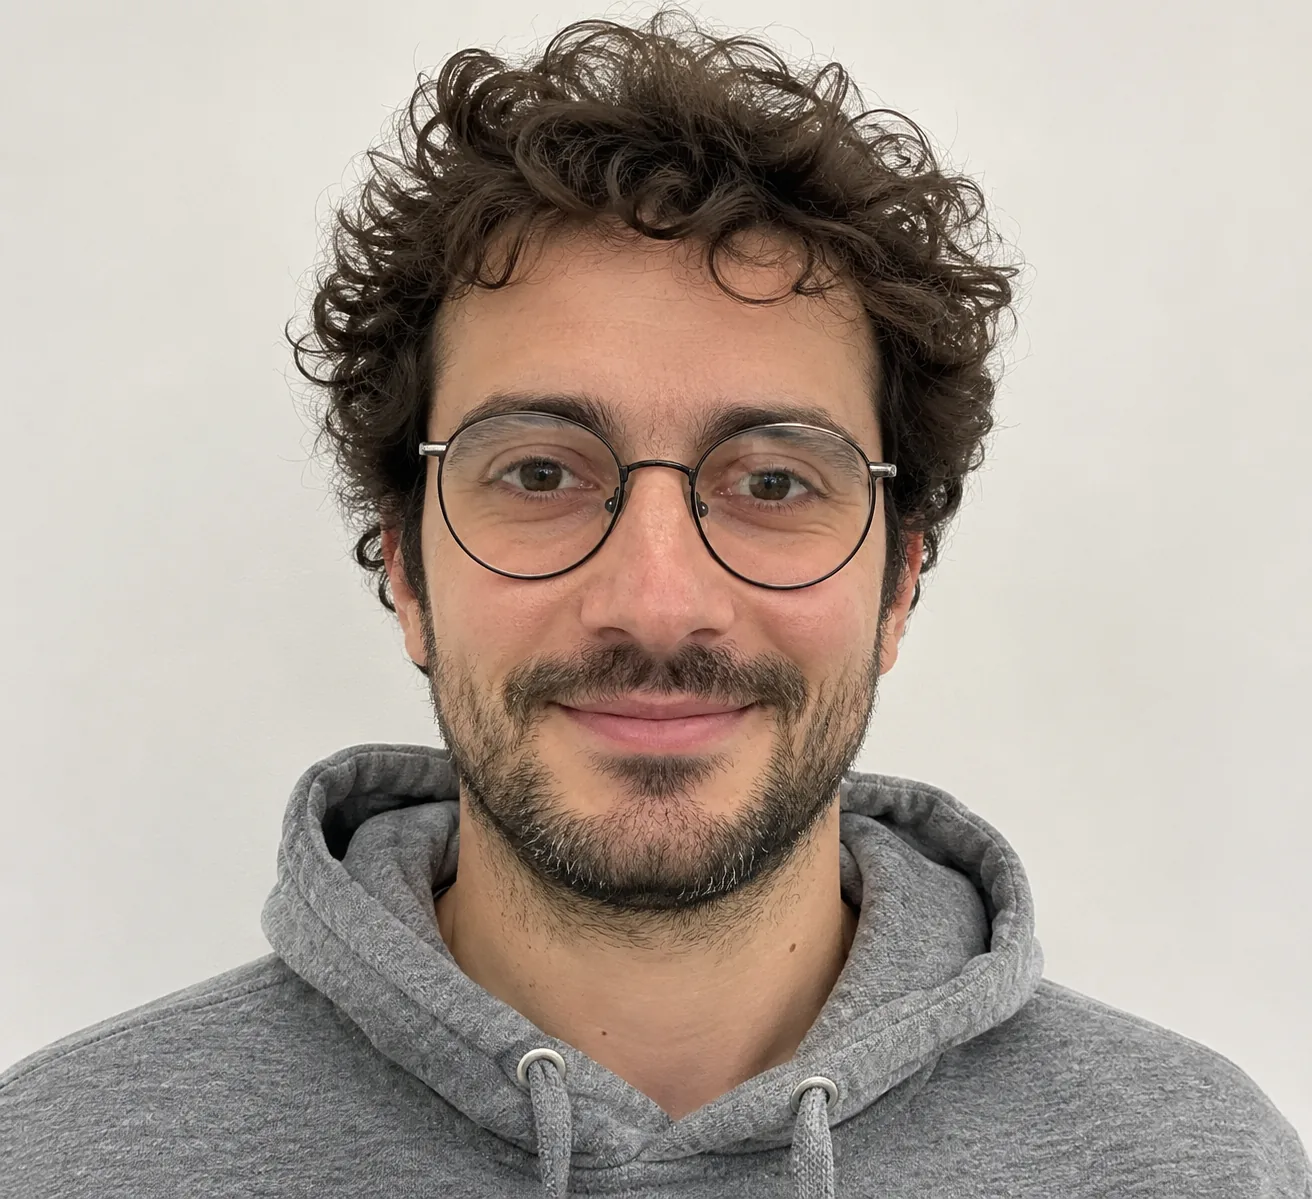
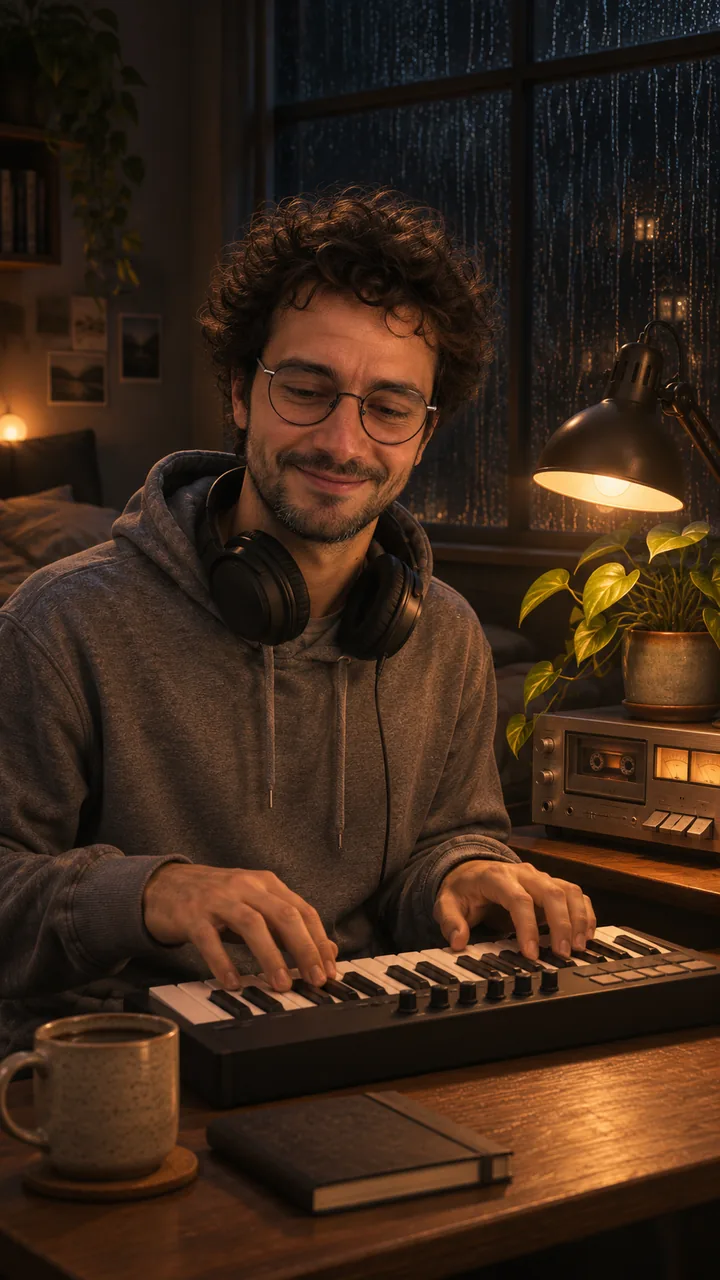
改編自 lovart.me 片段:Seedance 2.0 Fast,10 秒,9:16,720p,以一段 12 秒的原創 lo-fi 純音樂(Suno V6)作為音訊參考;聲音由模型依該參考生成 · 依節拍重新剪輯、重新取景、調色 · 未再進行 AI 生成 · 製作於 2026-11-05
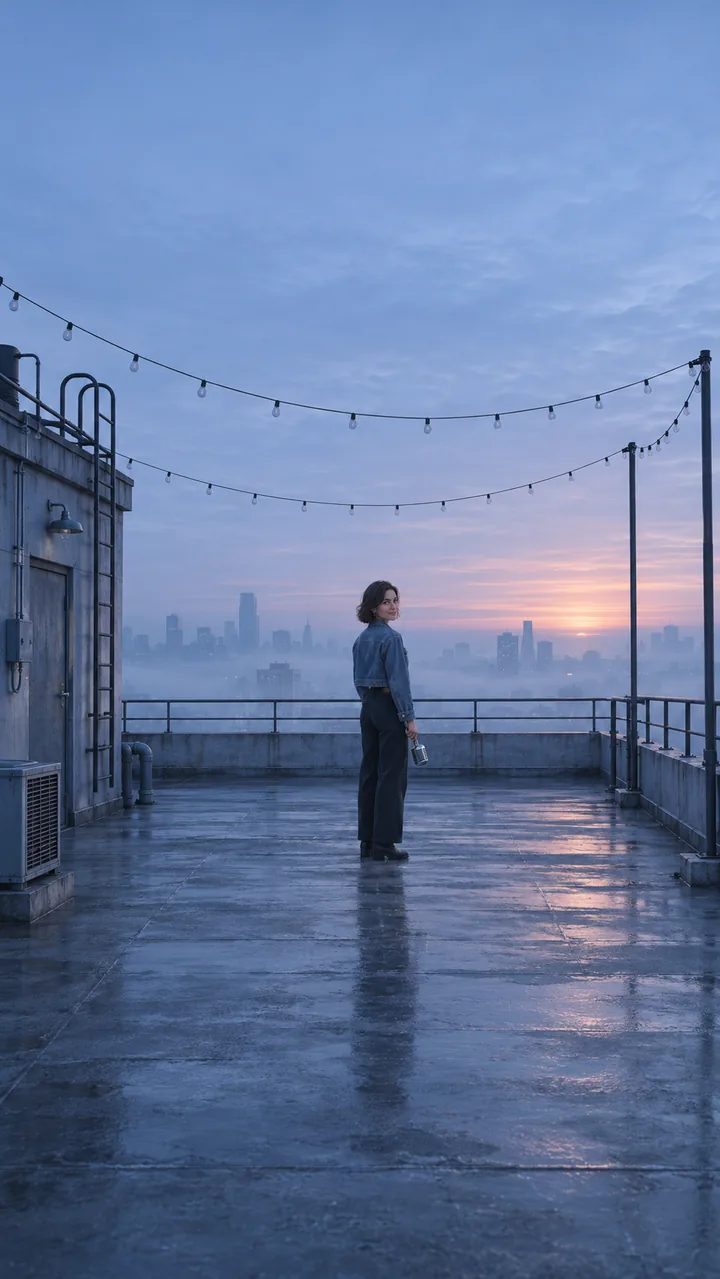
定格圖:GPT Image 2.5 Flare,圖生圖,9:16 · 僅定格圖 · 製作日期 2026-11-04
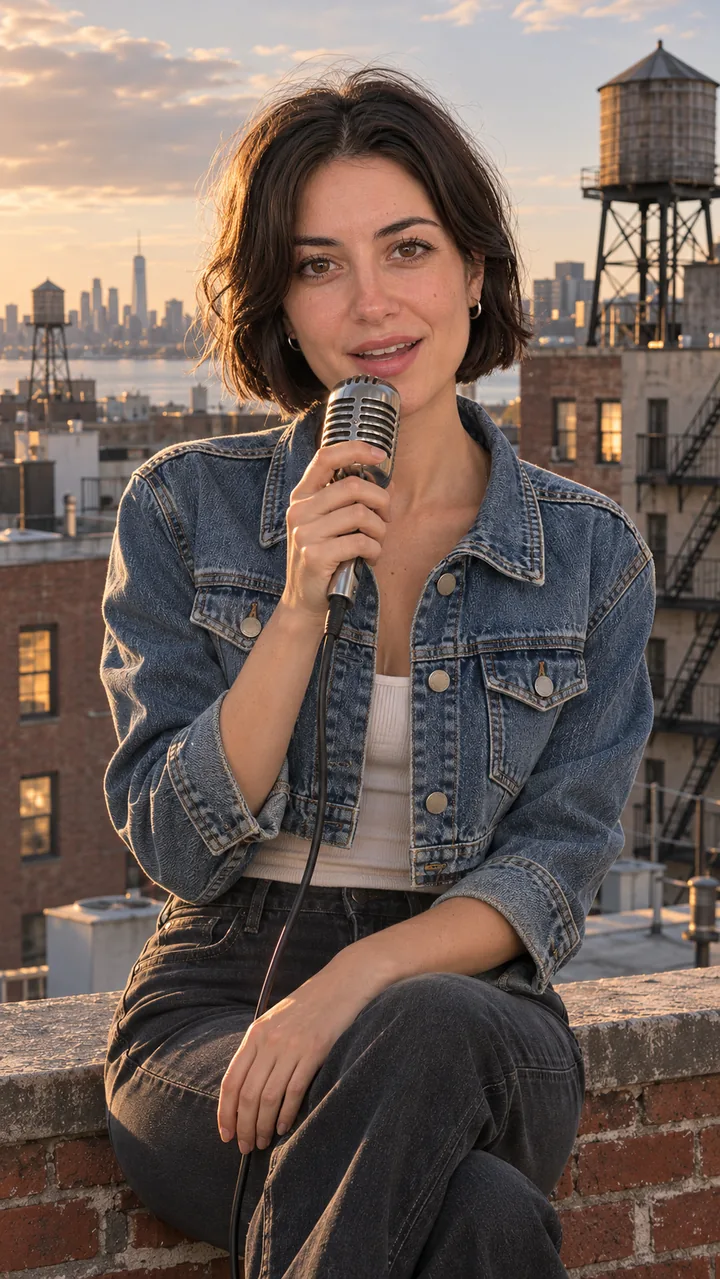
定格圖:GPT Image 2.5 Flare,圖生圖,9:16 · 僅定格圖 · 製作日期 2026-11-04
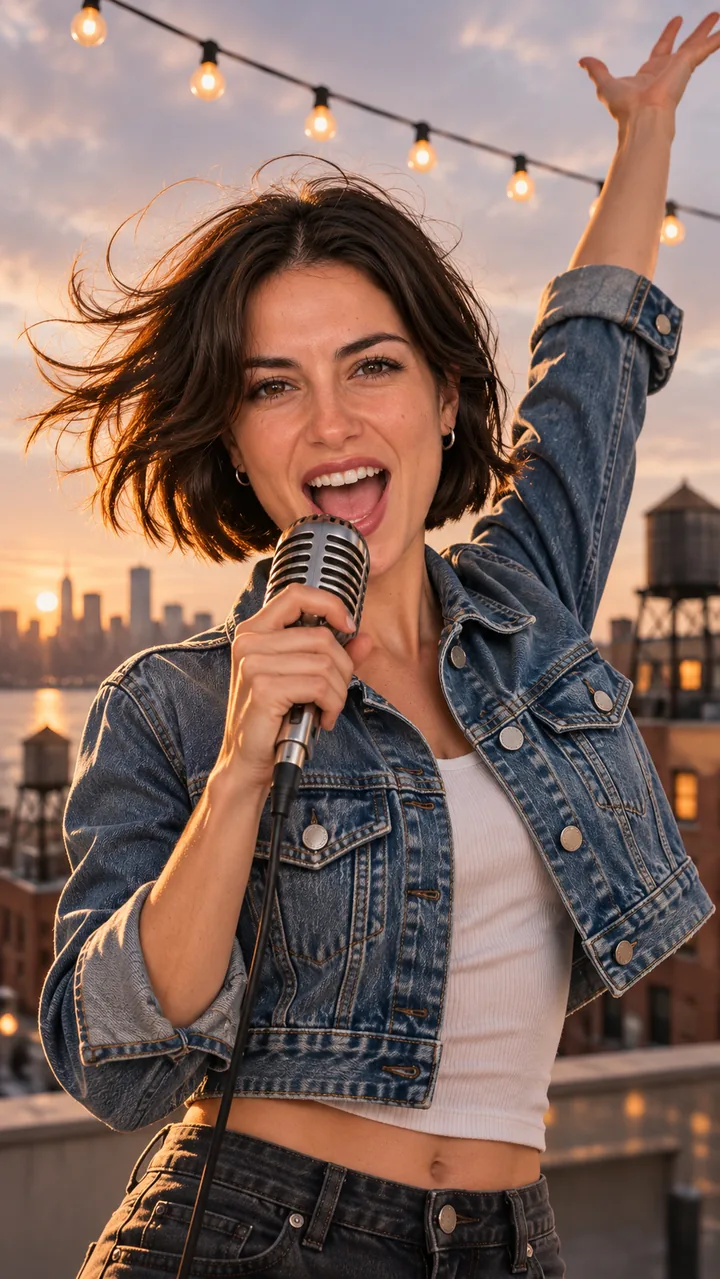
定格圖:GPT Image 2.5 Flare,圖生圖,9:16 · 僅定格圖 · 製作日期 2026-11-04
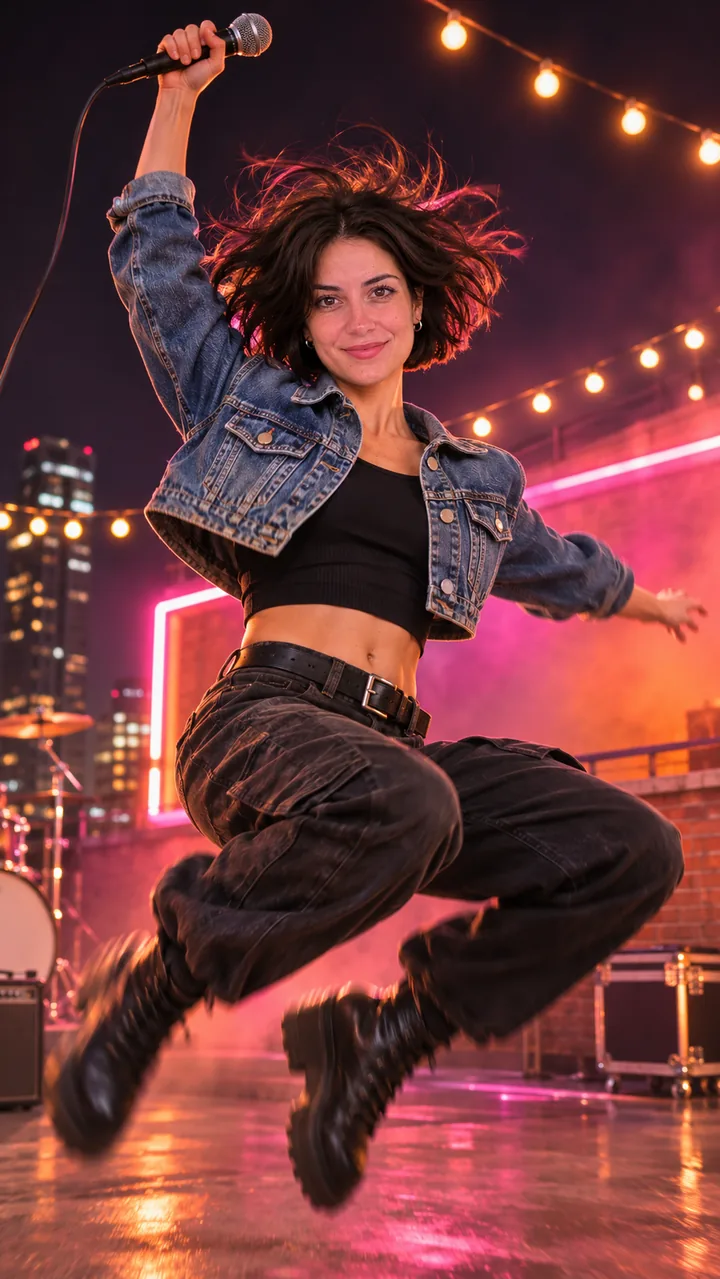
定格圖:GPT Image 2.5 Flare,圖生圖,9:16 · 僅定格圖 · 製作日期 2026-11-04
兩位歌手都是原創的成年角色,並非真實藝人,兩首歌也都是原創。這兩段片段曾在 lovart.me 以 Seedance 2.0 Fast 各生成一次,並分別附上一段 12 秒的 Suno V6 歌曲作為音訊參考,所以你聽到的聲音是模型依該參考生成的,而不是直接取自歌曲檔案。為本頁已依節拍重新剪輯、重新取景並調色,未再進行 AI 生成。段落靜態圖於 2026 年 11 月 4 日用 GPT Image 2.5 Flare 製作。 最後核對日期 .
第一步:用 AI Music 寫歌或帶入自己的歌;第二步:為每個段落製作靜態圖並讓它動起來,再用任何剪輯軟體把片段接到歌曲上。
在 AI Music 用一句話描述歌曲,或上傳自己的歌。記下 BPM 和副歌開始的秒數。
上傳一張歌手照片,選擇副歌、前奏、主歌或 Drop,再按「製作靜態圖」。每個段落都使用同一張照片。
為每個段落按下「讓它動起來」,下載片段後在任何剪輯軟體中對齊歌曲,並在小節線上剪接。
標出前奏、主歌、副歌和 Drop,各配一張靜態圖,並依小節數決定片段長度:118 BPM 時 8 小節約 16 秒,所以做兩個 8 秒的片段。
通常是較短、尺寸較小或帶浮水印的片段:HeyGen 和 Freebeat 可免費開始但有限制,而在這裡,你可以先用靜態圖步驟和 AI Music 測試想法,再決定是否生成影片。
寫明是誰、在哪裡、隨節拍的動作和鏡頭運動,並讓每段提示詞結束在下一個段落開始的畫面。
Keep the same person from my photo: same face, hair and clothes. They sing full voice into a vintage handheld microphone on a city rooftop at golden hour, one arm raised, wind in the hair, string lights overhead, low angle, shallow depth of field. Vertical 9:16 music video frame, the singer fully in view. No text, no lyrics on screen, no logos, no real celebrities. Use the photo as the first frame. One continuous shot, no cuts. Arm swings down on the downbeat, a step toward the camera every two beats, hair moving in the wind, the camera rises slowly from a low angle. Keep the same face, hair and clothes in every frame. No text, no logos.
Keep the same person from my photo: same face, hair and clothes. They sit on a low brick parapet on a city rooftop in late afternoon light, singing softly into a vintage handheld microphone, medium shot at eye level, water towers behind. Vertical 9:16 music video frame, the singer fully in view. No text, no lyrics on screen, no logos, no real celebrities. Use the photo as the first frame. One continuous shot, no cuts. Small head nods on every beat, the free hand taps the knee, the camera drifts slowly to the side. Keep the same face, hair and clothes in every frame. No text, no logos.
效果模式不行,它是在沒有你音訊的情況下讓畫面動起來;若要讓動作跟著歌曲,請在 Seedance 2.5 模型頁面把歌曲附為音訊參考,並讓特寫演唱的片段保持簡短。
為 TikTok 和 Reels 匯出 9:16;當音樂或場景看起來真實時,加上 YouTube 的 AI 標示;為 Spotify Canvas 剪出一段 3 到 8 秒、沒有演唱的循環片段。
可以免費開始:HeyGen 和 Freebeat 都有免費方案,但對長度、解析度或下載次數有限制。在這裡,每次生成影片前都能先確認各段落的靜態圖,費用也會顯示在每個按鈕上。
需要,或者自己做一首:在 AI Music 描述想要的歌、下載後,記下 BPM 和副歌開始的位置。這兩個數字決定每個片段的長度。
以小節數計算:118 BPM 時 8 小節約 16 秒,所以一首三分鐘的歌大約需要 12 到 20 個片段,再用剪輯軟體接起來。
可以。先做好段落片段,再到剪輯軟體中加入對齊時間的歌詞字幕。生成的畫面請不要放文字,因為圖像和影片模型常把字寫錯。
不行。Suno 免費方案製作的歌曲僅限非商業用途,且所有權歸 Suno;在 Pro 或 Premier 訂閱期間製作的歌曲則具有商業使用權。你自己寫的歌詞仍歸你所有。
每個片段都是一次新的生成。請用同一張靜態圖作為每個段落的首幀,並逐字沿用歌手的描述。
先寫歌,或把歌手放在固定的舞台上。